
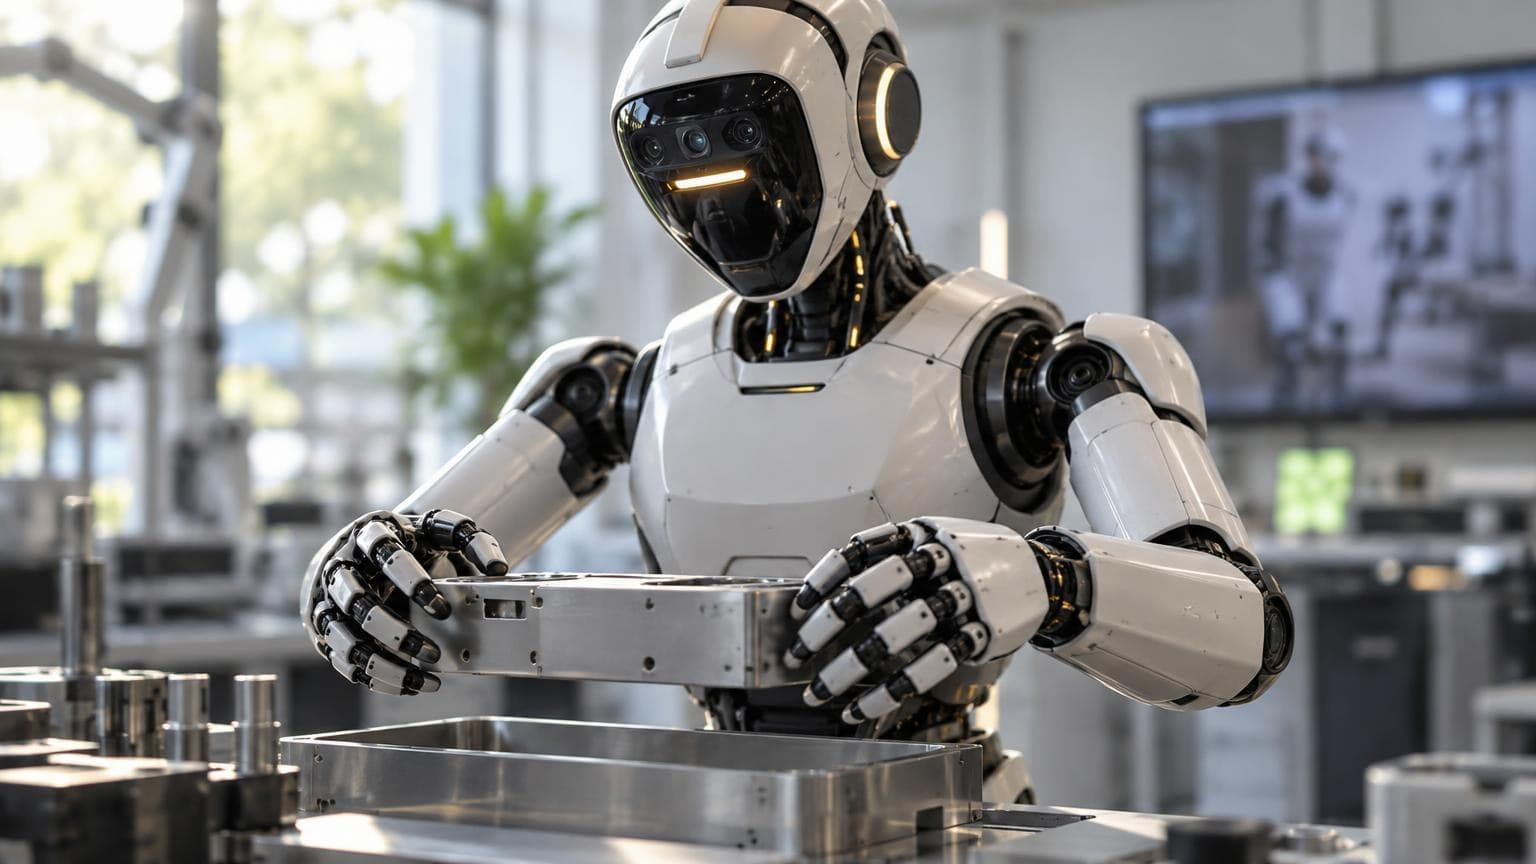
GR00T 2 получает видео, инструкцию и данные о состоянии робота, затем предсказывает, как изменится сцена, и планирует движения. Робот выполняет часть плана, после чего модель строит следующий. Такой подход позволяет учиться на человеческих видео, а отдельные модули управления переводят план в команды для моторов.
В тестах Nvidia робот с двумя пятипалыми кистями выстелил лабораторную воронку фильтровальной бумагой и смочил её из промывалки в 65% испытаний, хотя модель обучалась только на видео человека. Манипулятор YAM собрал игрушечный самосвал в 60% попыток после демонстраций с захватом UMI — ручным устройством для записи движений.
На 50 задачах, которых не было в данных для целевого робота, GR00T 2 без дообучения справилась в 40% попыток. Пять демонстраций на задачу и 30 минут дообучения на одной RTX 5090 повысили результат до 95%. Nvidia также выложила на Hugging Face 100 тыс. часов видео людей из набора Human-1M-100K по лицензии CC BY 4.0, разрешающей коммерческое использование.
Компактная версия GR00T 2 Turbo с 2 млрд параметров работала непосредственно на гуманоиде Unitree G1. В тестах она подавала попкорн во всех 48 попытках и убирала со стола разные предметы в 93% случаев.
Компании пока тестируют модель для отдельных задач: Nexuni — для работы с бельём, Foxconn — для автоматизации производства серверов, Siemens — для промышленных сценариев.